confluent-kafka-go에는 두 가지 방식으로 Kafka 메시지를 produce 할 수 있다.
첫 번째는 ProduceChannel()로, go channel에 메시지를 쓰는 방식이고, 두 번째는 Produce() 함수에 메시지를 넘기는 방식이다.
ProduceChannel은 현재 deprecated 됐고, 대부분의 producer는 Produce() 함수를 이용하는 추세다.
두 방식 모두 librdkafka라는 C 라이브러리에 실제 전송을 위임한다. 차이점은 메시지가 라이브러리의 전송 큐에 도달하기 까지의 과정에 있다.
ProduceChannel(): 채널을 이용하여 메시지 전달
gop.ProduceChannel() <- msg
ProduceChannel()의 타입은 chan *kafka.Message로 발행하려는 메시지를 channel에 전송하는 형태로 보내야 한다.
본문이 1 KiB인 메시지를 보낸다고 가정해보자.
메시자가 버퍼에서 대기하는 동안 채널 한 칸에서 본문까지 따라가 보면 이렇게 생겼다.
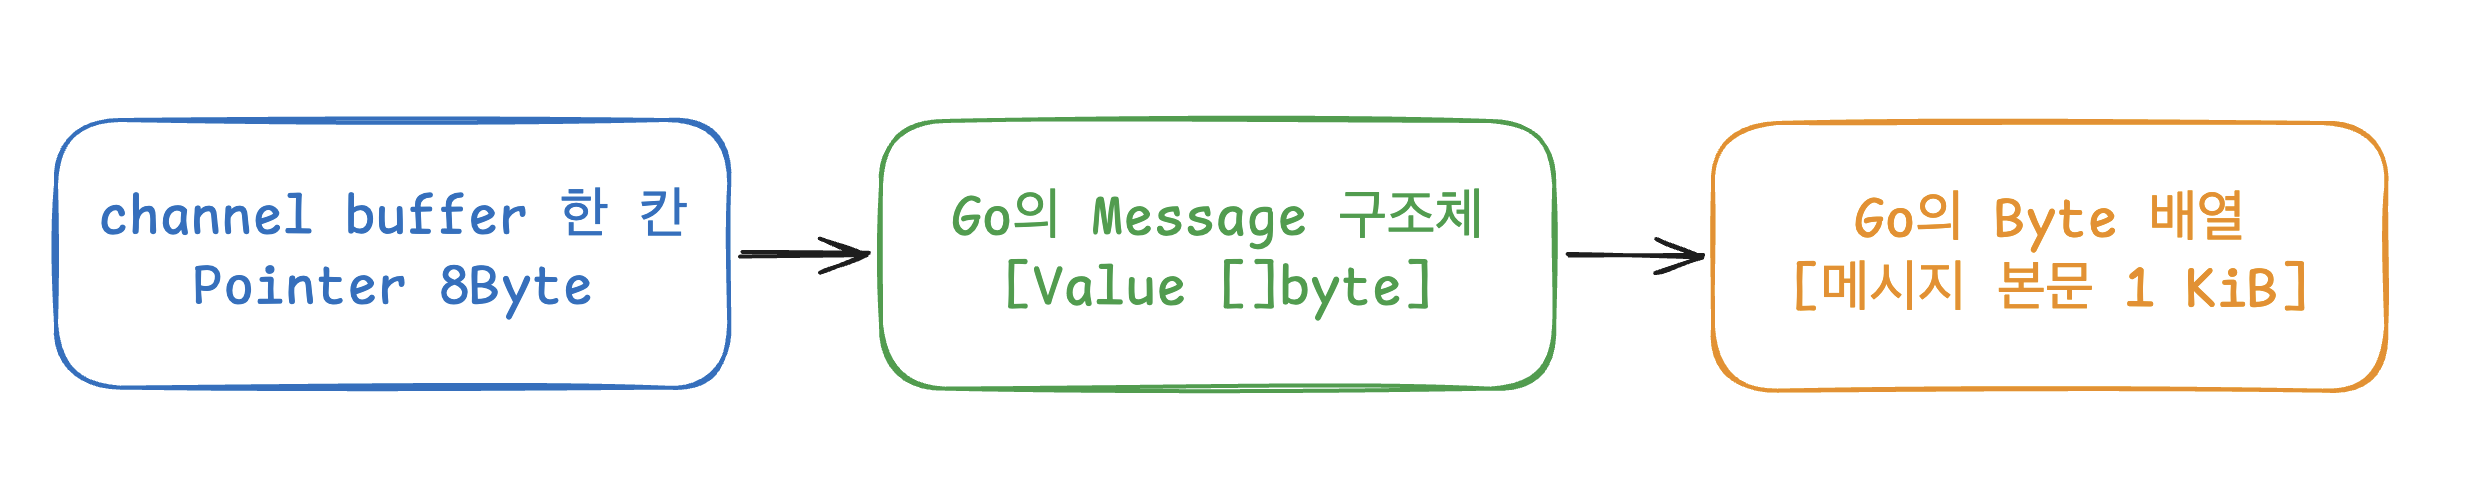
channel에 메시지를 넣을 때 복사되는 값은 8바이트짜리 포인터 하나로, 메시지 내용 자체는 Go 바이트 배열에 그대로 있고 Message.Value가 포인터의 배열을 가리킨다.
메시지가 버퍼에서 기다리는 동안에는 이 참조를 따라 본문에 닿을 수 있어서 Go의 가비지 컬렉터도 본문을 회수하지 않는다.
- 참고: Message 구조체 정의
go// Message represents a Kafka message
type Message struct {
	TopicPartition TopicPartition
	Value          []byte
	Key            []byte
	...
}
SDK(confluent-kafka-go) 고루틴이 위 이미지의 buffer에서 메시지를 꺼내면 다음 순서로 메시지 본문이 전송 큐에 들어간다.
- 고루틴이 채널 버퍼에서
*kafka.Message포인터 하나를 읽는다. - SDK는 그 포인터로 구조체의
Value에 접근해 본문 배열의 시작 주소와 길이(1KiB, 여기서는 1,024바이트)를 librdkafka에 넘긴다. - librdkafka는 그 주소에서 1,024바이트를 읽어 자신이 관리하는 C 메모리에 복사한다.
즉 p.ProduceChannel() <- msg가 실행되면 Go 채널이 메시지를 받고, SDK의 고루틴이 채널에서 메시지를 꺼내 librdkafka의 전송 큐에 넣는다. 전송 큐가 가득 차면 고루틴이 먼저 기다린다.
그동안 애플리케이션은 go application 채널의 버퍼가 가득 찰 때 까지 메시지를 쓸 수 있고, 그 자리까지 다 차면 다시 위 라인에서 기다린다.
Produce()로 전송 큐에 넣기
goif err := p.Produce(msg, deliveryCh); err != nil {
    return err
}
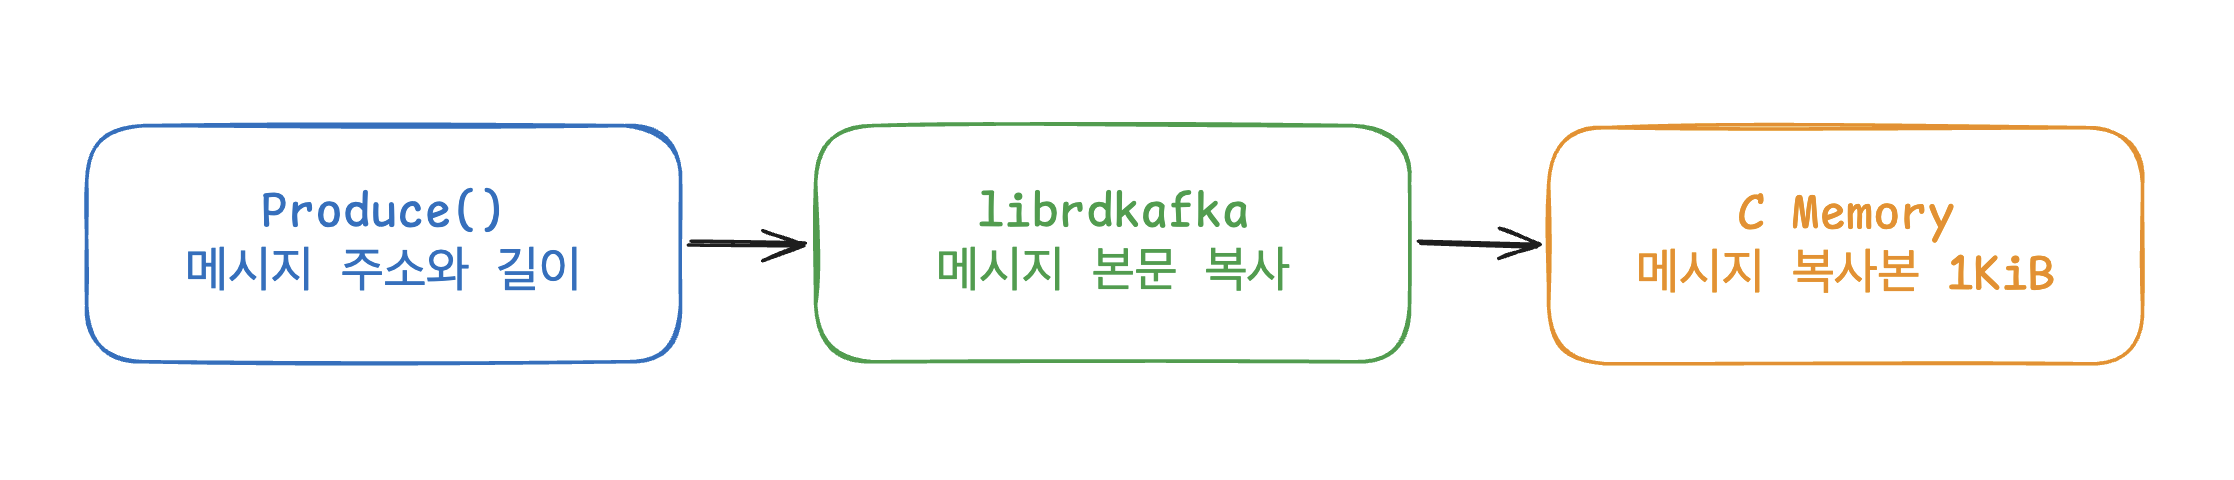
반면 Produce(msg, deliveryCh)를 호출하면 메시지 포인터(msg)가 내부 함수 p.produce로 바로 넘어간다. ProduceChannel()을 쓰면 Go 클라이언트의 고루틴이 채널에서 포인터를 꺼낸 뒤 같은 함수(p.produce)를 호출하는 것 보다 한 단계를 생략할 수 있다.
본문을 복사하는 과정은 두 방식 모두 동일하다. SDK가 msg.Value의 시작 주소와 길이를 넘기면, librdkafka가 그 주소에서 1,024바이트를 읽어 C 메모리에 복사한다. p.ProduceChannel() <- msg가 끝나도 본문 복사는 아직 시작되지 않았을 수 있다. Produce()가 nil을 반환하면 librdkafka는 이미 본문을 C 메모리에 복사한 상태다.
두 방식의 차이
p.ProduceChannel() <- msg가 끝나면 Go 채널이 포인터를 받아들인 상태다. SDK 고루틴이 아직 본문을 읽기 전일 수 있으므로 이 시점에 원본 바이트를 덮어쓰면 안 된다.p.Produce(msg, deliveryCh)가nil을 반환하면 본문 복사와 전송 큐 등록이 모두 끝났다. 이때부터 원본 바이트 버퍼를 재사용할 수 있다. 큐가 가득 차면 호출한 자리에서ErrQueueFull을 받을 수 있고, 큐에 들어간 메시지의 실제 전송 결과는 나중에deliveryCh로 받은 메시지의TopicPartition.Error에서 확인한다.
그래서 왜 이런 두 방식이 존재하는걸까? 우선 두 방식 모두 초기 버전부터 함께 존재했는데, 2022년 11월 Confluent는 채널 방식에서 Len()과 Flush()의 결과를 신뢰하기 어렵다는 점을 문서에 명시하고 ProduceChannel()을 deprecated 시켰다.
현재 confluent 팀이 권장하는 방식은 Produce()다.
이 글을 쓰게 된 계기는 프로듀서마다 ProduceChannel()용 메시지 포인터 100만 개를 담을 버퍼를 미리 할당한다는 걸 알게됐기 때문이다.
사용하지 않는 채널에 왜 버퍼를 100만개 씩이나 미리 할당하나?
100만이라는 기본값은 channel 발행을 지원하던 최초 구현부터 존재했다.
당시 코드에서 정확히 100만을 택한 이유까지는 찾지 못했는데, 현재 사내에서 사용중인 v2.12.0에서도 NewProducer()는 앱이 어느 방식으로 발행할지와 관계없이 설정값을 읽어 아래 한 줄을 실행한다. 설정을 생략하면 produceChannelSize에 100만이라는 값이 디폴트로 할당된다. 초기 기본값 · v2.12.0의 설정과 할당
gop.produceChannel = make(chan *Message, produceChannelSize)
여기서 한 칸은 채널의 내부 배열에 메시지 포인터 하나를 보관할 자리다. 64비트 환경에서 포인터는 8바이트이므로 빈 채널도 100만 칸의 배열에 8,000,000바이트(약 7.63 MiB)를 쓴다. 프로듀서가 두 개면 약 15.26 MiB를 차지한다.
운영 서버 개선
위 내용을 알게 되고 ai의 도움을 받아 이벤트용·로그용 Kafka 프로듀서 두 개의 버퍼를 go.produce.channel.size=1로 수정했다.(기존: 1M -> 수정: 1)
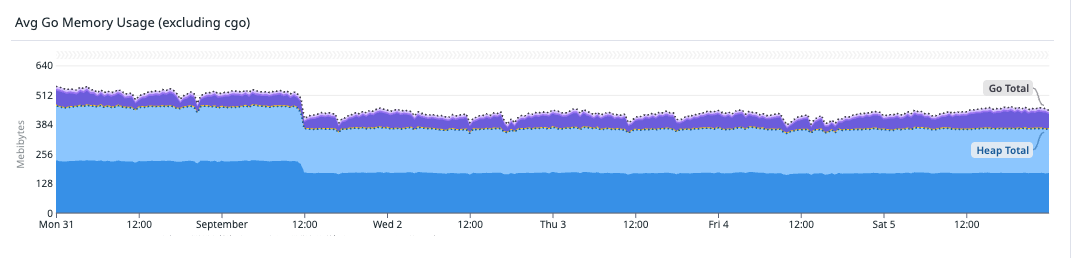
베포 전후의 평균 Go 메모리 사용량(cgo 제외, MiB). 배포 당일 지표가 낮아졌고 이후 며칠 동안 배포 전보다 낮은 수준을 유지했다.
Pyroscope 프로파일에서 프로듀서 생성 함수(newConfluentProducer)가 차지한 보유 힙 비중은 24.39%에서 2.16%로 줄었고, CPU 샘플 중 GC와 힙 스캔에 쓰인 비중도 13.09%에서 9.80%로 3.29%p 낮아졌다.
| 운영 지표 | 배포 전 | 배포 후 |
|---|---|---|
| Kafka 발행량 | 14,507건/초 | 14,630건/초 |
| Go live heap | 224.5 MiB | 173.3 MiB |
| 앱 컨테이너 RSS | 493.0 MiB | 446.7 MiB |
| Kafka 발행 지연 (5분별 p95의 평균) | 764.9 ms | 764.0 ms |
비슷한 발행량에서 Go live heap은 약 23%, 컨테이너 RSS는 약 9% 낮았다. produce latency p95는 양쪽 모두 약 764~765 ms 정도로 균일했다. 이 서비스에서 눈에 띈 효과는 같은 규모의 메시지를 보내면서 파드마다 쓰는 메모리가 줄었다는 점이다.